Un dato personale entrato in un modello AI si può cancellare? Il parere del Garante sulla Provincia di Trento e i chatbot in azienda
Valerio Nicolai · · 7 minuti di lettura
Un dato personale entrato in un modello AI non si cancella come una riga di database. Il Garante privacy ha appena posto il problema a un ente pubblico, ma la domanda riguarda ogni azienda che addestra un modello sui propri documenti o lascia che i dipendenti incollino dati nei chatbot.
La Provincia autonoma di Trento vuole addestrare modelli di intelligenza artificiale sui propri documenti e usarli negli uffici, a partire dal protocollo. Nella valutazione d'impatto ha messo per iscritto un limite che molti progetti AI preferiscono tacere: se una persona chiede di correggere o cancellare un suo dato quando il modello è già addestrato, la correzione si fa sul documento originale e vale per i cicli di addestramento successivi. Il modello in uso resta com'è.
Il Garante, con il parere n. 760 del 7 ottobre 2026, ha detto che così non basta. Ha dato parere favorevole al regolamento della Provincia, a condizione che preveda misure capaci di rendere effettivi la correzione, la cancellazione (il cosiddetto diritto all'oblio) e gli altri diritti delle persone, come accesso, limitazione e opposizione, qualunque sia il modello usato. Ha anche indicato come opportuna una regola specifica che li faccia funzionare sui modelli già addestrati. Il parere favorevole è condizionato a queste integrazioni.
Una parte della risposta è già nello schema, anche se solo per i dati più delicati. Per i dati giudiziari la Provincia ha previsto che nell'addestramento si usino «esclusivamente dati sintetici o, in subordine, dati reali pseudonimizzati o mascherati». Per i dati comuni, invece, lo schema ammette anche dati anagrafici e di contatto. La strada dei dati giudiziari è quella che affronta il problema alla radice, e vale la pena capire perché.
Perché togliere un dato dal modello è difficile
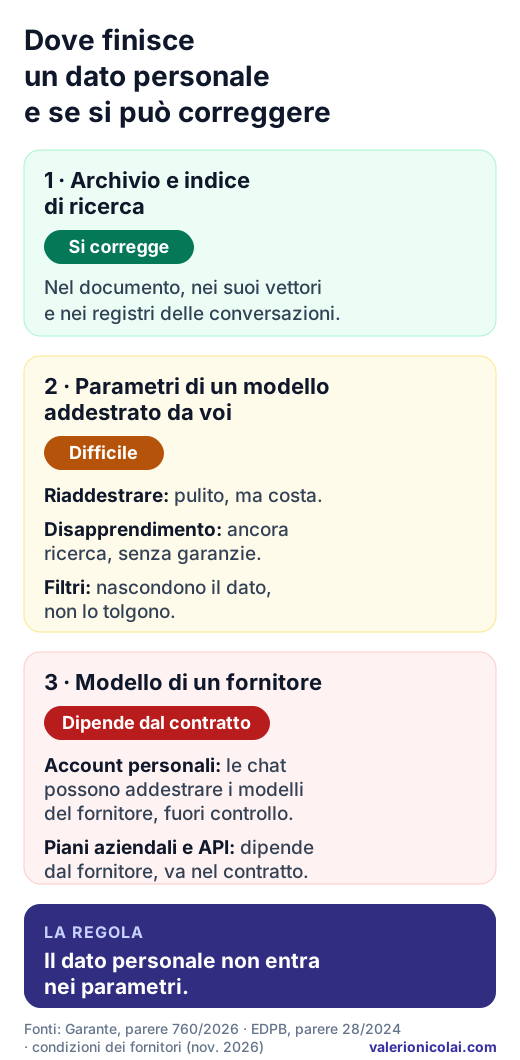
Addestrare un modello significa fargli assorbire le informazioni dei documenti nei suoi parametri, e da lì non si cancellano come da un archivio. Il Comitato europeo per la protezione dei dati, nel parere 28/2024 richiamato dal Garante, osserva che in certi casi quei dati possono esserne estratti o ricavati anche se il modello non è fatto per restituirli. Non c'è un record da cancellare.
Le strade per rimediare dopo sono tre, e nessuna è comoda. Si può riaddestrare il modello senza quel dato: è il metodo più pulito, e il Comitato lo cita fra le misure con cui rimediare a un addestramento illecito, ma un riaddestramento completo costa e richiede tempo, e se si fa solo al ciclo successivo il dato resta nel modello in uso fino ad allora, che è proprio il limite contestato alla Provincia. Se invece l'adattamento è un piccolo strato sopra un modello di terzi, rifarlo senza il dato costa molto meno. Si possono usare tecniche di «disapprendimento» (machine unlearning), che cercano di togliere l'effetto di un dato senza riaddestrare: sono ancora materia di ricerca e non danno garanzie verificabili. Oppure si mettono filtri sulle risposte, che impediscono al modello di restituire il dato ma non lo tolgono, e non servono più se il modello esce dall'azienda.
La soluzione più solida: il dato personale non entra nel modello
Se nei parametri che addestrate voi non entrano dati personali, correzione e cancellazione restano sull'archivio e sull'insieme di addestramento. Fra le misure che il Comitato europeo elenca per ridurre l'impatto sulle persone c'è proprio la sostituzione, nell'insieme di addestramento, di nomi, indirizzi email e altri dati personali con dati fittizi, indicata come particolarmente adatta quando il contenuto personale non serve allo scopo.
Succede più spesso di quanto si pensi. Un modello che aiuta a protocollare deve riconoscere il mittente della lettera che ha davanti, ma lo legge dal documento al momento: non ha bisogno di ricordare chi ha scritto le migliaia di lettere su cui ha imparato. I dati delle persone restano nell'archivio, e quando serve un documento specifico l'assistente lo recupera lì al momento della richiesta. Correggere o cancellare un dato torna a essere un'operazione sull'archivio e sull'indice di ricerca: si toglie il documento, si ricalcolano i suoi vettori nell'indice, si puliscono copie temporanee e registri delle conversazioni. Sono operazioni che si possono fare e verificare, a patto di averle previste.
Questo impianto ha due vantaggi pratici. La cancellazione non dipende dal fornitore del modello: non serve chiedergli di riaddestrare né aspettare che il disapprendimento diventi affidabile. E non dipende da quanto sia tecnicamente possibile togliere un dato dai parametri, perché lì il dato non è mai entrato.
Ci sono limiti da conoscere. Il mascheramento va verificato, perché nei testi liberi un nome, un indirizzo o un dettaglio che rende riconoscibile qualcuno può sfuggire; un controllo a campione prima di ogni addestramento è il minimo. I dati pseudonimizzati restano dati personali: riducono il rischio, ma non lo tolgono. Anche i dati sintetici generati da dati reali vanno controllati, perché possono riprodurne frammenti. E un modello di base preso da terzi contiene già dati di persone note, imparati dal web, e può generare su una persona un'informazione sbagliata anche senza averla mai vista: questo resta un problema a parte.
Che cosa vale per un'azienda
Il parere riguarda un ente pubblico, ma i diritti di correzione e cancellazione valgono, alle condizioni del GDPR, verso qualunque azienda. Chi pensa di addestrare o adattare un modello sui propri documenti, offerte, ticket di assistenza, pratiche, ha davanti la stessa domanda della Provincia, e conviene porsela prima di partire: quali dati personali entrerebbero nei parametri, e servono davvero? Nella maggior parte dei casi il modello ha bisogno del contenuto, come si scrive un'offerta o come si risponde a un reclamo, non dei nomi dei clienti.
Chi invece usa un assistente che cerca nei documenti senza addestrare nulla ha i dati in posti dove si possono correggere: l'archivio, l'indice di ricerca, i registri delle conversazioni. A una condizione, però: che il fornitore del modello non li usi a sua volta per addestrare i propri.
Il modello che non controllate: quello del fornitore
È il caso più frequente e il meno visto. Un dipendente incolla in un chatbot la mail di un cliente, un contratto, l'elenco dei candidati a una selezione. Se lo fa con un account personale, quei dati possono finire nell'addestramento dei modelli del fornitore. Lì l'azienda non ha leve contrattuali per correggerli o cancellarli, mentre la responsabilità verso il cliente resta sua.
Non è un'ipotesi: è scritto nelle condizioni dei servizi più diffusi.
- OpenAI dichiara che con i piani Free, Plus e Pro può usare i contenuti per addestrare i propri modelli, salvo che l'utente lo disattivi dalle impostazioni; la disattivazione vale per le nuove conversazioni. Anche dopo, se l'utente dà un riscontro su una risposta (pollice su o giù), l'intera conversazione può essere usata per l'addestramento.
- Anthropic dal 2025 addestra i nuovi modelli sui dati degli account Claude Free, Pro e Max, anche quando si usa Claude Code, se l'utente lo consente nelle impostazioni, e in quel caso li conserva fino a cinque anni.
- Google, per l'app Gemini con l'attività salvata, scrive di usarla anche per addestrare modelli di AI generativa. Una parte delle conversazioni è letta da revisori umani, e quelle lette restano conservate fino a tre anni.
- DeepSeek indica l'addestramento dei modelli fra gli scopi del trattamento, e la privacy policy indica un'email come canale per opporsi. La stessa policy indica come titolare la società di Hangzhou e dice che i dati sono raccolti, trattati e conservati nella Repubblica Popolare Cinese; per l'Unione ha nominato un rappresentante. In Italia il Garante privacy, con il provvedimento del 30 gennaio 2025, ha ordinato alle due società DeepSeek la limitazione del trattamento dei dati delle persone che si trovano in Italia, rilevando fra l'altro la conservazione dei dati in Cina.
Neanche un server in Europa basta, da solo, a chiudere la questione. Alibaba Cloud offre i modelli Qwen anche dalla regione di Francoforte, ma la sua documentazione separa due cose: i dati salvati restano nella regione scelta, mentre le richieste vengono mandate a elaborare ai nodi di calcolo dell'«ambito» scelto. A Francoforte gli ambiti sono due. «EU» è un ambito con confini geografici definiti, quello che la documentazione consiglia a chi ha vincoli di conformità. «Global» dà accesso a un bacino di risorse più ampio. La documentazione non indica dove si trovino i nodi dell'ambito «Global»; per un altro ambito, «International», precisa invece che esclude la Cina continentale. Chi usa questi servizi con dati personali deve scegliere l'ambito EU e verificarlo nel contratto.
Gli stessi fornitori trattano diversamente i servizi per le aziende. OpenAI non usa per impostazione predefinita i dati di ChatGPT Business, Enterprise, Edu e dell'API per migliorare i modelli. Anthropic esclude dall'addestramento i piani Team ed Enterprise e l'API, anche tramite Amazon Bedrock e Google Vertex AI. Google rinvia a condizioni diverse per gli account di lavoro. Due avvertenze valgono per tutti: non addestrare non vuol dire non conservare, perché anche sui piani aziendali le conversazioni possono restare per un periodo, per esempio per il controllo degli abusi; e anche con i fornitori statunitensi i dati possono essere trattati fuori dall'Unione. Quanto e dove, lo dicono il contratto e l'accordo sul trattamento dei dati.
La conseguenza per un'azienda è semplice. Se il dato personale entra nel modello di un fornitore, siamo di nuovo nel caso della Provincia, ma peggio: il modello non è vostro, e la correzione o la cancellazione dipendono da qualcun altro. La regola che regge è la stessa vista sopra, applicata a monte. I dati dei clienti e dei dipendenti vanno solo in servizi con un contratto aziendale e un accordo sul trattamento dei dati che escludano l'addestramento, mai negli account personali, e la regola va scritta e comunicata a chi lavora. Per le aziende questo è il punto da verificare per primo, prima ancora di chiedersi come togliere un dato da un modello.
Aggiornato al 6 novembre 2026. Il parere è sintetizzato dall'autore; fa fede il testo pubblicato dal Garante (doc. web 10312627). Le condizioni dei fornitori sono riportate come pubblicate alla data di aggiornamento e possono cambiare. Articolo informativo, non consulenza legale sul caso specifico.
Fonti
- Garante per la protezione dei dati personali — Parere sullo schema di regolamento di attuazione dell'art. 40-ter.1 della l.p. 23/1992 della Provincia autonoma di Trento, provv. n. 760 del 7 ottobre 2026 (doc. web 10312627) · Decisione di un'autorità
- Garante per la protezione dei dati personali — Newsletter n. 555 del 29 ottobre 2026 · Decisione di un'autorità
- Comitato europeo per la protezione dei dati (EDPB) — Parere 28/2024 su alcuni aspetti di protezione dei dati relativi al trattamento nell'ambito dei modelli di AI (adottato il 17/12/2024) · Linee guida
- Garante per la protezione dei dati personali — Provvedimento del 30 gennaio 2025 n. 33 nei confronti di Hangzhou DeepSeek e Beijing DeepSeek (doc. web 10098477) · Decisione di un'autorità
- OpenAI — How your data is used to improve model performance (documentazione del fornitore, verificata il 6/11/2026) · Stampa o blog
- Anthropic — Updates to our Consumer Terms and Privacy Policy (28/8/2025, documentazione del fornitore) · Stampa o blog
- Google — Gemini Apps Privacy Hub (aggiornato a ottobre 2026, documentazione del fornitore) · Stampa o blog
- DeepSeek — Privacy Policy (aggiornata al 10/2/2026, documentazione del fornitore) · Stampa o blog
- Alibaba Cloud — Model Studio, Regions and endpoints (aggiornato al 6/11/2026, documentazione del fornitore) · Stampa o blog
- Alibaba Cloud — Model Studio, regione di Singapore e ambito International (documentazione del fornitore) · Stampa o blog
Contenuto informativo, aggiornato alla data indicata: non è un parere legale. Le norme sull'AI cambiano spesso, verifica sempre i testi ufficiali.
Vuoi capire cosa cambia per la tua azienda?
Scrivimi in due righe